AI ヘルパー
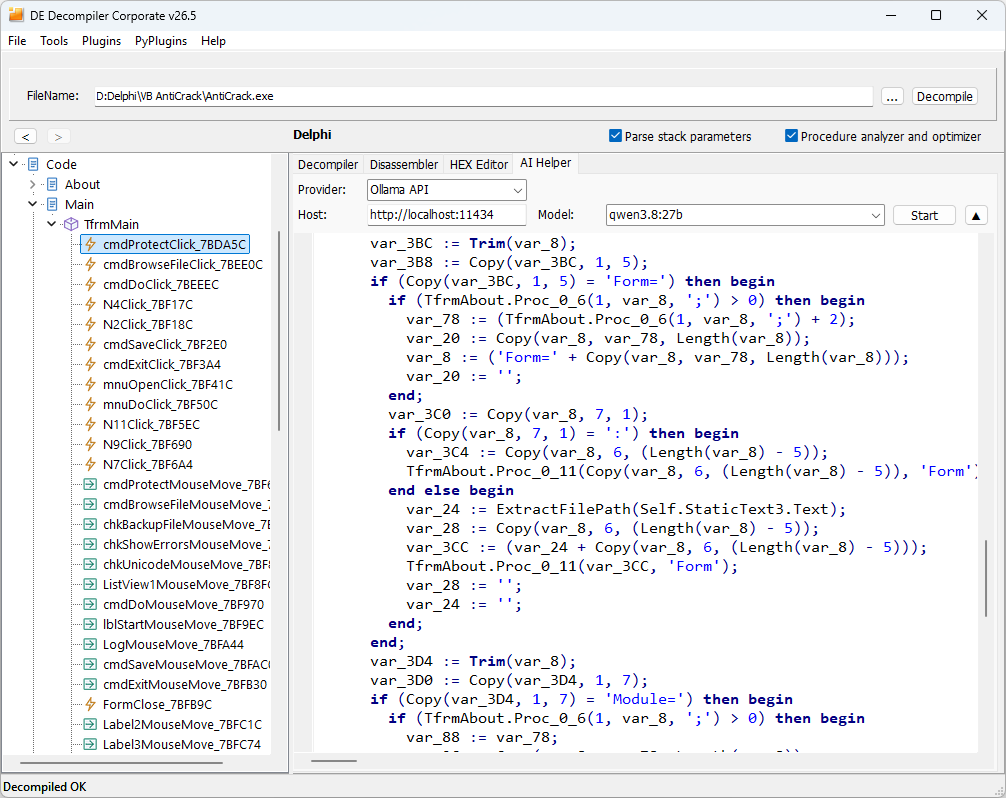
AI Helperは、対応するDelphiまたはC++BuilderのプログラムからDE Decompilerが復元した、Delphi風のPascalコードを処理します。Ollama経由のローカルモデルと、OpenAI API連携を利用するOpenAI(ChatGPT)およびDeepSeekのオンラインモデルに対応しています。
- プロシージャを開き、その逆コンパイラ (Decompiler) 出力を確認します。
- 選択 AI 支援 (AI Helper).
- Provider を選択し、サーバーアドレスを設定してモデルを選択します。
- 処理を開始し、提案された結果を元の逆コンパイルコードリストおよび機械語命令と比較します。
処理は別スレッドで実行され、折りたたまれたコードを含む表示中のプロシージャ全体を使用します。プロンプトではObject Pascalでの出力を指定し、未解決の呼び出し先や、出力用コメント内の復元コードを保持します。時間のかかるリクエストはキャンセル (Cancel)でキャンセルできます。補助的な接続設定を折りたたむと、コードの表示領域を広く取れます。
Ollama
互換性のあるワークステーションまたはサーバーで Ollama を実行し、必要なモデルをインストールしてから、AI Helper をそのインスタンスに接続します。ローカルの Ollama サーバーは通常 http://localhost:11434 を使用します。モデルは、Host フィールドによって選択されたインスタンスにインストールされている必要があります。
モデルの選択とGPUメモリ
qwen3:8b のような軽量モデルは、復元された Delphi コードの処理において限られた改善しか提供しません。このマニュアルでは、より大きな qwen3.8:27b モデルが示されています。
このローカル qwen3.8:27b 設定には、以下の GPU メモリに関するガイダンスを使用してください:
| 構成 | GPUメモリ | 想定される用途 |
|---|---|---|
| 最小限 | 16 GB VRAM | 処理は非常に遅くなる可能性があります。これはエントリーレベルの構成であり、通常のモデル使用に適した快適なワークステーションではありません。 |
| 推奨 | 32 GB VRAM | 図示されたモデルをローカルで通常使用するための最適な構成です。 |
これらの数値は、Ollama によってサポートされる GPU の専用ビデオメモリを指します。システム RAM および古い統合グラフィックス アダプターで報告される共有メモリ数値は、専用 VRAM と同等ではありません。古い統合グラフィックスを搭載した Pentium M 時代のコンピュータは、このセットアップには適していません。GPU を選択する前に、Ollama ハードウェア互換性 を確認してください。
要件はOllamaを実行しているコンピュータに適用されます。AI Helperが別のOllamaサーバーに接続する場合、そのサーバーがモデルリソースを提供する必要があります。
コンテキストとその他のモデル
コンテキスト長はOllamaの設定画面のスライダーで選択します。この構成に外部拡張機能のインストールは必要ありません。コンテキストはトークン数で表され、モデルへの指示、入力コード、生成される回答を含みます。コンテキストを長くすると必要なメモリも増えるため、上記の容量であらゆるモデル形式やコンテキスト長を利用できるとは限りません。
設定したプロバイダーが対応する他のモデルも選択できます。モデルによって出力の品質や書式が異なり、モデル固有の補助テキストが結果に残る場合があります。生成されたコードは、使用前に確認してください。
オンラインモデル: OpenAI (ChatGPT) および DeepSeek
プロバイダー で OpenAI API を選択して、OpenAI モデル (ChatGPT) または DeepSeek オンラインを使用します。選択したサービスに対して ホスト、API キー、および モデル を設定します。ホスト、API キー、およびモデル識別子は同じサービスに属している必要があり、その API キーで利用可能なモデルを使用してください。
DeepSeek は同じ OpenAI API プロバイダーを使用します。DeepSeek のホスト、API キー、およびモデル識別子を対応するフィールドに入力します。オンライン推論はプロバイダーのインフラストラクチャ上で実行されるため、これらのサービスを使用する場合、ローカルの Ollama GPU メモリ推奨事項は解析ワークステーションには適用されません。
データ処理
API キーをスクリーンショットや共有された調査資料から除外してください。
AI Helper は、現在逆コンパイルされたコードを選択したサービスに送信します。別のワークステーション上のサーバーまたは外部 API が、そのコードを解析者のコンピュータの外に配置する可能性があります。独自のソース、サンプル、および調査証拠の取り扱い要件に従ってエンドポイントを選択してください。
提案の確認
AI はより明確な名前、宣言、または制御フローを提案できますが、提案はバイナリの動作の証明ではありません。変更された呼び出し、条件、および型を逆アセンブリコードと関連するプロシージャに対して確認してください。モデル支援による解釈を記録する際は、元の逆コンパイル結果を保持してください。
接続とモデルのトラブルシューティング
- モデルが欠落している場合は、ホスト によって選択された Ollama インスタンスにそのモデルがインストールされていることを確認してください。
- によって選択された Ollama インスタンスにインストールされていることを確認してください。応答がない場合は、サービスに到達可能であることを確認し、ホスト、API キー、およびモデル識別子が同じプロバイダーを指していることを確認してください。
- 処理が遅すぎる場合は、リクエストをキャンセルし、Ollama ホストのリソース、モデルサイズ、コンテキスト設定を確認してください。
- 見慣れないモデルが補助タグやサービステキストを残す場合、結果を確認しながらそのテキストを削除するか、別の適切なモデルを選択してください。