Содержание справки · Справка в PDF
AI Helper
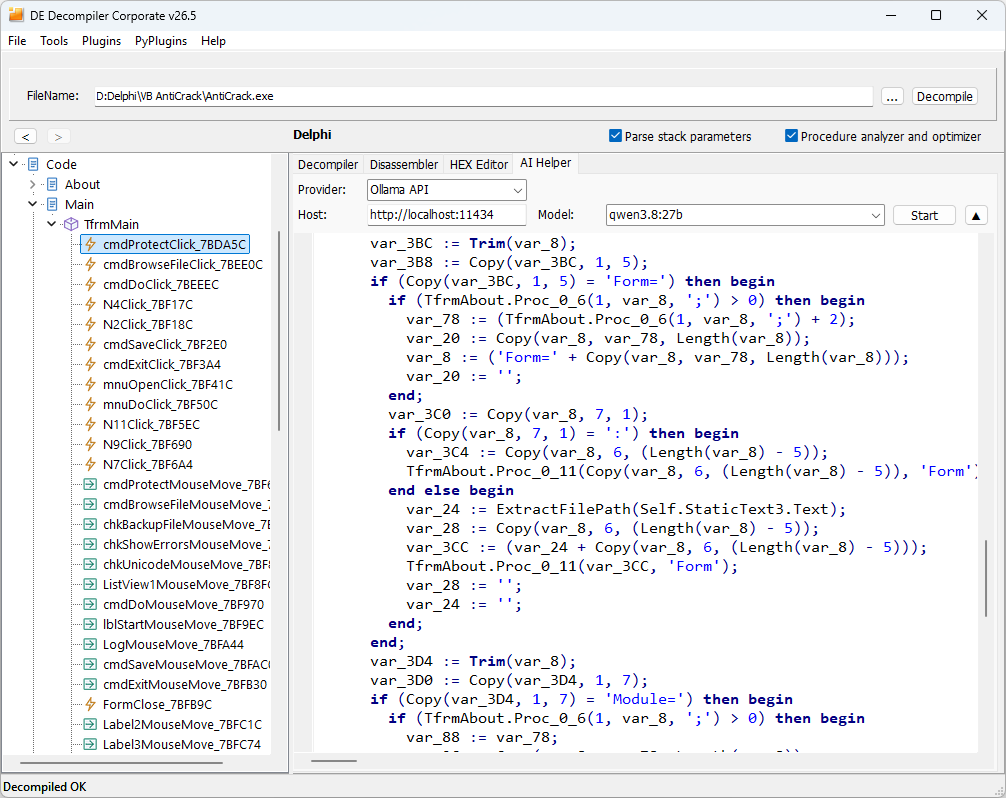
AI Helper обрабатывает Delphi-подобный Pascal, уже восстановленный DE Decompiler из поддерживаемых программ, написанных на Delphi или созданных в C++Builder. Доступны локальные модели через Ollama и онлайн-модели OpenAI (ChatGPT) и DeepSeek через интеграцию OpenAI API.
- Откройте процедуру и просмотрите ее «Декомпилятор» (Decompiler) вывод.
- Выберите «ИИ Помощник» (AI Helper).
- Выберите Поставщикустановите адрес сервера и выберите модель.
- Запустите обработку и сравните предложение с исходным декомпилированным листингом и нативными инструкциями.
Обработка выполняется в отдельном потоке и использует текущую процедуру целиком, включая свёрнутый код. Промпт запрашивает результат на Object Pascal и сохраняет обозначения нераспознанных вызовов и восстановленный код внутри обрамляющих комментариев экспорта. Для отмены долгого запроса используйте «Отмена» (Cancel). Дополнительные настройки подключения можно свернуть, освободив место для кода.
Ollama
Запустите Ollama на совместимой рабочей станции или сервере, установите там необходимую модель и подключите AI Helper к этому экземпляру. Локальный сервер Ollama обычно использует http://localhost:11434. Модель должна быть установлена в экземпляре, выбранном в поле Хост .
Выбор модели и объём памяти GPU
Лёгкие модели, такие как qwen3:8b обеспечивают лишь ограниченное улучшение при обработке восстановленного кода Delphi. Более крупная qwen3.8:27b модель показана в данном руководстве.
Для данной локальной qwen3.8:27b конфигурации используйте следующие рекомендации по объёму памяти GPU:
| Конфигурация | Память GPU | Ожидаемое использование |
|---|---|---|
| Минимальные | 16 ГБ видеопамяти | Обработка может быть очень медленной. Это конфигурация начального уровня, не подходящая для комфортной рабочей станции при регулярном использовании модели. |
| Рекомендуемые | 32 ГБ видеопамяти | Предпочтительная конфигурация для регулярного локального использования указанной модели. |
Эти значения относятся к выделенной видеопамяти на GPU, поддерживаемом Ollama. Оперативная память системы и показатель общей памяти, отображаемый для старого интегрированного графического адаптера, не эквивалентны выделенной видеопамяти. Компьютер эпохи Pentium M со старым интегрированным графическим чипом не подходит для этой настройки. Проверьте Ollama совместимость оборудования перед выбором GPU.
Требования относятся к компьютеру, на котором выполняется Ollama. Если AI Helper подключается к отдельному серверу Ollama, этот сервер должен предоставлять ресурсы модели.
Контекст и другие модели
Размер контекста задаётся ползунком в настройках Ollama; дополнительные расширения Ollama для этого не требуются. Контекст измеряется в токенах и включает инструкции модели, входной код и ответ. При увеличении контекста требуется больше памяти, поэтому приведённые выше объёмы не гарантируют, что любая конфигурация модели и контекста поместится в видеопамять.
Вы можете выбрать другие модели, поддерживаемые настроенным провайдером. Качество вывода и форматирование могут отличаться, а специфичный для модели служебный текст может остаться в результате. Просматривайте сгенерированный листинг перед использованием.
Онлайн-модели: OpenAI (ChatGPT) и DeepSeek
Выберите OpenAI API в Поставщик для использования онлайн-моделей OpenAI (ChatGPT) или DeepSeek. Установите Хост, Ключ API и Модель для выбранного сервиса. Хост, ключ API и идентификатор модели должны принадлежать одному сервису; используйте модель, доступную по этому ключу API.
DeepSeek использует тот же OpenAI API провайдер. Введите хост DeepSeek, ключ API и идентификатор модели в соответствующие поля. Онлайн-инференс выполняется на инфраструктуре провайдера, поэтому локальные рекомендации по объему памяти GPU Ollama не применяются к рабочей станции анализа при использовании этих сервисов.
Обработка данных
Не допускайте попадания ключей API в скриншоты и материалы совместного расследования.
AI Helper отправляет текущий декомпилированный код в выбранный сервис. Сервер на другой рабочей станции или внешний API может поместить этот код за пределы компьютера аналитика. Выбирайте конечную точку в соответствии с требованиями вашей организации к обработке проприетарного исходного кода, образцов и доказательств расследования.
Проверка предложений
ИИ может предлагать более понятные имена, объявления или структуру управления, но предложение не является доказательством поведения бинарного файла. Проверяйте измененные вызовы, условия и типы на основе дизассемблирования и связанных процедур. Сохраняйте исходный результат декомпиляции при записи интерпретации, полученной с помощью модели.
Устранение неполадок подключения и моделей
- Если модель отсутствует, убедитесь, что она установлена в экземпляре Ollama, выбранном Хост.
- Если ответ не поступает, проверьте доступность сервиса и то, что хост, ключ API и идентификатор модели относятся к одному провайдеру.
- Если обработка выполняется слишком медленно, отмените запрос и проверьте ресурсы хоста Ollama, размер модели и настройки контекста.
- Если незнакомая модель оставляет вспомогательные теги или служебный текст, удалите этот текст при просмотре результата или выберите другую подходящую модель.